खबरों में क्यों
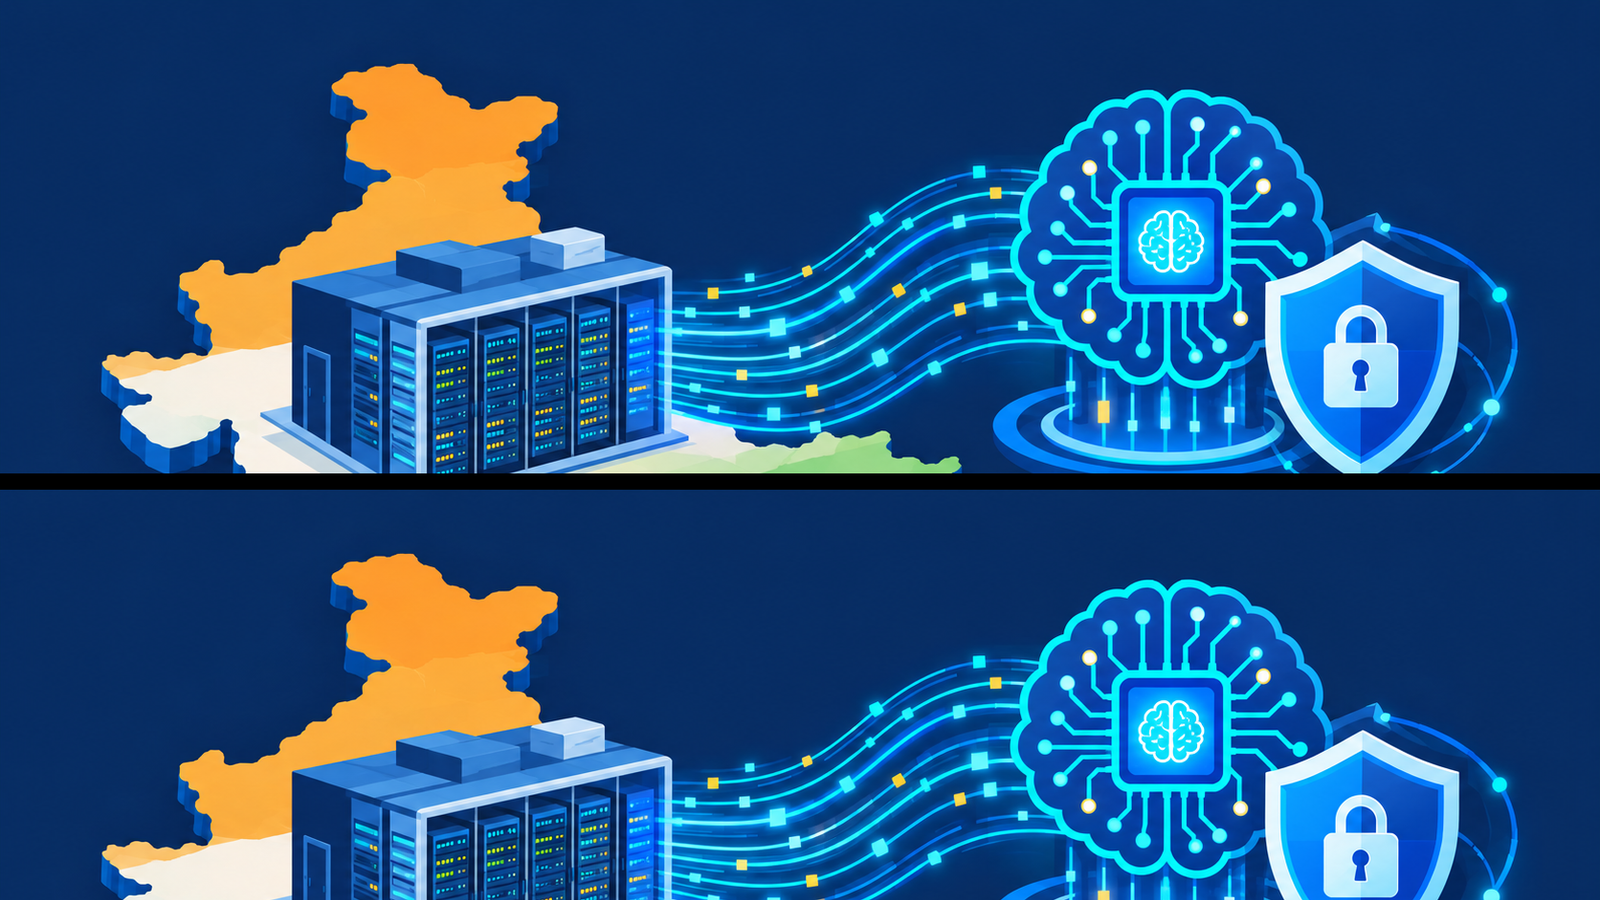
12 नवंबर 2026: OpenAI ने घोषणा की कि भारत में अपने एप्लीकेशन प्रोग्रामिंग इंटरफेस (API) के लिए लोकल प्रोसेसिंग और इनफरेंस की सुविधा उपलब्ध कराई जाएगी। इसका अर्थ है कि पात्र भारतीय कंपनियों और डेवलपर्स के API अनुरोधों की प्रोसेसिंग और उत्तर तैयार करने वाली मॉडल गणना (कम्प्यूटेशन) अब भारत के भीतर स्थित सर्वरों पर ही होगी। शुरुआत में यह सुविधा कंपनी के GPT-6 Luna मॉडल के लिए है। इस कदम का लक्ष्य उन संगठनों तक AI पहुँचाना है जो डेटा-स्थान संबंधी अनिवार्यताओं, विशेषकर वित्तीय सेवाओं के नियमों, के कारण अभी तक AI का पूरा इस्तेमाल नहीं कर पा रहे थे।
लोकल प्रोसेसिंग और डेटा रेजिडेंसी में क्या अंतर है
मई 2025 में OpenAI ने भारत सहित जापान, सिंगापुर और दक्षिण कोरिया में डेटा रेजिडेंसी की सुविधा शुरू की थी, जिसके तहत ग्राहक सामग्री का भंडारण (storage) चुने गए देश में होता था, परंतु अनुरोध की प्रोसेसिंग और मॉडल गणना देश के बाहर होती रहती थी। नई सुविधा के साथ भंडारण के साथ-साथ प्रोसेसिंग और गणना भी भारत में ही होगी। कंपनी के अनुसार कुछ भारतीय कंपनियाँ महत्वपूर्ण कार्यों के लिए AI को पूरी तरह अपना नहीं पा रही थीं, क्योंकि उन्हें जानकारी की प्रोसेसिंग देश के भीतर ही चाहिए थी।
यह सुविधा फिलहाल Responses API और Chat Completions API के माध्यम से GPT-6 Luna के इनपुट और आउटपुट तक सीमित है। पात्र ग्राहक API प्लेटफॉर्म पर नया प्रोजेक्ट बनाकर भंडारण और प्रोसेसिंग दोनों के लिए भारत चुन सकते हैं और भारतीय क्षेत्रीय एंडपॉइंट का उपयोग कर सकते हैं। कंपनी के अनुसार API इनफरेंस रेजिडेंसी अन्य क्षेत्रों में भी उपलब्ध है; भारत, ऑस्ट्रेलिया और जापान इसे पाने वाले नवीनतम बाजारों में शामिल हैं।
डेटा स्थानीयकरण क्या है
डेटा स्थानीयकरण (data localisation) का अर्थ है डेटा को उसी देश की सीमा के भीतर संग्रहित, प्रोसेस या प्रबंधित करने की आवश्यकता, जहाँ वह उत्पन्न हुआ है। इसके पक्ष में तर्क दिए जाते हैं – नागरिकों के डेटा पर राष्ट्रीय अधिकार-क्षेत्र, कानून-प्रवर्तन की पहुँच, सुरक्षा और विदेशी निगरानी से बचाव। आलोचना इस आधार पर होती है कि इससे कंपनियों की लागत बढ़ती है और वैश्विक डेटा प्रवाह बाधित होता है।
भारत में डेटा स्थानीयकरण का कानूनी ढांचा
डिजिटल व्यक्तिगत डेटा संरक्षण (DPDP) अधिनियम, 2023: यह कानून सामान्य रूप से डेटा स्थानीयकरण अनिवार्य नहीं करता। धारा 16(1) के तहत केंद्र सरकार अधिसूचना द्वारा किसी निर्दिष्ट देश या क्षेत्र में व्यक्तिगत डेटा के हस्तांतरण पर प्रतिबंध लगा सकती है – यानी हस्तांतरण सामान्यतः स्वतंत्र है, केवल प्रतिबंधित गंतव्यों को छोड़कर। धारा 16(2) स्पष्ट करती है कि किसी अन्य भारतीय कानून के अधिक कठोर प्रावधान लागू रहेंगे। इसके अतिरिक्त, महत्वपूर्ण डेटा फिड्यूशरी (Significant Data Fiduciary) के लिए सरकार निश्चित श्रेणियों के डेटा को भारत में ही रखने की शर्त लगा सकती है। ध्यान देने योग्य है कि धारा 16 और DPDP नियम, 2025 का नियम 15 अभी लागू नहीं हुए हैं; नवंबर 2025 की प्रारंभ अधिसूचनाओं के अनुसार ये 13 मई 2027 से प्रभावी होने की उम्मीद है।
भारतीय रिजर्व बैंक का निर्देश (6 अप्रैल 2018): ‘Storage of Payment System Data’ परिपत्र के तहत पेमेंट सिस्टम से जुड़ा संपूर्ण डेटा केवल भारत में स्थित सिस्टम में संग्रहित करना अनिवार्य है। लेनदेन की प्रोसेसिंग विदेश में की जा सकती है, परंतु प्रोसेसिंग के बाद डेटा भारत में ही संग्रहित होना चाहिए। वित्तीय सेवाओं पर लागू यही कठोर क्षेत्रीय आवश्यकता उन कंपनियों के लिए AI अपनाने के फैसले में प्रमुख विचार बनती है – और यही वह बाधा है जिसे लोकल इनफरेंस दूर करने का लक्ष्य रखता है।
भारत के AI पारिस्थितिकी तंत्र से जुड़ाव
इसी वर्ष OpenAI ने ‘OpenAI for India’ पहल शुरू की थी, जिसमें AI बुनियादी ढांचा, उद्यमों द्वारा अपनाना, कौशल विकास और स्थानीय साझेदारी शामिल हैं; इसके तहत टाटा समूह के साथ घरेलू AI डेटा-सेंटर क्षमता विकसित करने की साझेदारी भी शामिल है। लोकल इनफरेंस की सुविधा इसी विस्तार की एक कड़ी है और भारत में AI अवसंरचना के बढ़ते निवेश को दर्शाती है।
प्रिलिम्स परीक्षा अभ्यास प्रश्न
प्रश्न 1. डिजिटल व्यक्तिगत डेटा संरक्षण (DPDP) अधिनियम, 2023 के संदर्भ में निम्नलिखित कथनों पर विचार कीजिए:
1. यह सभी व्यक्तिगत डेटा का भारत के भीतर ही भंडारण अनिवार्य करता है।
2. धारा 16 के अंतर्गत केंद्र सरकार किसी निर्दिष्ट देश में व्यक्तिगत डेटा के हस्तांतरण पर प्रतिबंध लगा सकती है।
3. धारा 16(2) के तहत किसी अन्य भारतीय कानून के अधिक कठोर हस्तांतरण-संबंधी प्रावधान लागू रहेंगे।
उपर्युक्त कथनों में से कौन-से सही हैं?
(a) केवल 1 और 2
(b) केवल 2 और 3
(c) केवल 1 और 3
(d) 1, 2 और 3
उत्तर और व्याख्या
उत्तर: (b)
कथन 1 गलत है – DPDP अधिनियम सामान्य डेटा स्थानीयकरण अनिवार्य नहीं करता; हस्तांतरण सामान्यतः स्वतंत्र है। कथन 2 सही है – धारा 16(1) केंद्र सरकार को निर्दिष्ट देशों के लिए हस्तांतरण प्रतिबंधित करने का अधिकार देती है। कथन 3 सही है – धारा 16(2) RBI जैसे नियामकों के अधिक कठोर कानूनों को बरकरार रखती है।
प्रश्न 2. OpenAI की भारत में लोकल इनफरेंस सुविधा के संदर्भ में निम्नलिखित कथनों पर विचार कीजिए:
1. इससे पहले ग्राहक डेटा का भंडारण भारत में संभव था, परंतु अब API अनुरोधों की प्रोसेसिंग भी भारत में होगी।
2. यह सुविधा शुरुआत में GPT-6 Luna मॉडल तक सीमित है।
3. यह सुविधा सभी निःशुल्क उपयोगकर्ताओं पर समान रूप से लागू होगी।
उपर्युक्त कथनों में से कौन-से सही हैं?
(a) केवल 1 और 2
(b) केवल 2 और 3
(c) केवल 1 और 3
(d) 1, 2 और 3
उत्तर और व्याख्या
उत्तर: (a)
कथन 1 सही है – मई 2025 की डेटा रेजिडेंसी केवल भंडारण तक सीमित थी; नई सुविधा प्रोसेसिंग और गणना भी भारत में कराती है। कथन 2 सही है – शुरुआत GPT-6 Luna मॉडल से हो रही है। कथन 3 गलत है – यह पात्र उद्यमों और डेवलपर्स के लिए API-आधारित सुविधा है, सभी निःशुल्क उपयोगकर्ताओं के लिए नहीं।
प्रश्न 3. भारतीय रिजर्व बैंक के ‘Storage of Payment System Data’ निर्देश (6 अप्रैल 2018) के संदर्भ में निम्नलिखित कथनों पर विचार कीजिए:
1. यह निर्देश पेमेंट सिस्टम से जुड़े डेटा के भंडारण से संबंधित है।
2. इसके अनुसार पेमेंट लेनदेन की प्रोसेसिंग किसी भी दशा में भारत से बाहर नहीं हो सकती।
उपर्युक्त कथनों में से कौन-सा/से सही है/हैं?
(a) केवल 1
(b) केवल 2
(c) 1 और 2 दोनों
(d) न तो 1, न ही 2
उत्तर और व्याख्या
उत्तर: (a)
कथन 1 सही है – निर्देश पेमेंट सिस्टम डेटा के भंडारण पर है और संपूर्ण डेटा केवल भारत में स्थित सिस्टम में रखना अनिवार्य करता है। कथन 2 गलत है – प्रोसेसिंग विदेश में की जा सकती है, परंतु प्रोसेसिंग के बाद डेटा भारत में ही संग्रहित होना चाहिए।
अक्सर पूछे जाने वाले प्रश्न (FAQ)
संक्षिप्त उत्तर: OpenAI ने 12 नवंबर 2026 को भारत में अपने API के लिए लोकल प्रोसेसिंग और इनफरेंस शुरू करने की घोषणा की – शुरुआत GPT-6 Luna मॉडल से। अब ग्राहक डेटा का भंडारण ही नहीं, अनुरोधों की प्रोसेसिंग और मॉडल गणना भी भारत में होगी। इससे वित्तीय सेवाओं जैसे डेटा-स्थान नियमों वाले क्षेत्रों को AI अपनाने में मदद मिलेगी। DPDP अधिनियम, 2023 सामान्य स्थानीयकरण अनिवार्य नहीं करता, परंतु RBI जैसे क्षेत्रीय नियामकों के कठोर नियम बरकरार हैं।
प्रश्न: OpenAI की नई लोकल प्रोसेसिंग सुविधा क्या है?
इसके तहत पात्र भारतीय कंपनियों और डेवलपर्स के API अनुरोधों की प्रोसेसिंग और उत्तर बनाने वाली मॉडल गणना भारत के भीतर स्थित सर्वरों पर होगी। शुरुआत में यह GPT-6 Luna मॉडल के लिए Responses API और Chat Completions API के माध्यम से उपलब्ध है।
प्रश्न: डेटा रेजिडेंसी और लोकल इनफरेंस में क्या अंतर है?
डेटा रेजिडेंसी (मई 2025 से उपलब्ध) के तहत केवल ग्राहक डेटा का भंडारण चुने गए देश में होता था, जबकि प्रोसेसिंग बाहर होती थी। लोकल इनफरेंस के साथ भंडारण के साथ-साथ अनुरोध की प्रोसेसिंग और मॉडल गणना भी भारत में ही होगी।
प्रश्न: क्या DPDP अधिनियम, 2023 भारत में डेटा स्थानीयकरण अनिवार्य करता है?
नहीं। यह कानून सामान्य स्थानीयकरण अनिवार्य नहीं करता; धारा 16(1) के तहत केंद्र सरकार केवल निर्दिष्ट देशों के लिए हस्तांतरण पर प्रतिबंध लगा सकती है। परंतु धारा 16(2) के कारण RBI के पेमेंट डेटा निर्देश (2018) जैसे अधिक कठोर क्षेत्रीय प्रावधान लागू रहते हैं, जिनमें भारत में ही भंडारण अनिवार्य है।
स्रोत (Sources):
- Economic Times – OpenAI brings local inference to India (12 नवंबर 2026)
- Livemint – OpenAI goes local in India (12 नवंबर 2026)
- OpenAI – Introducing data residency in Asia (आधिकारिक ब्लॉग)
- भारतीय रिजर्व बैंक – Storage of Payment System Data (परिपत्र FAQ)
- DSCI – Cross-border flow of data (पेपर)
- Legal500 – DPDP Act: cross-border data transfers (विश्लेषण)
इस लेख को डाउनलोड करें: PDF

PCSMANTRA संपादकीय टीम
शोध और संपादन
हम UPSC, राज्य PCS, PCS-J और अन्य प्रतियोगी परीक्षाओं के लिए हिंदी और अंग्रेज़ी में सामयिक घटनाओं का विश्लेषण, परीक्षा-अपडेट और अध्ययन-सामग्री तैयार करते हैं। हर लेख आधिकारिक स्रोतों से सत्यापित कर प्रकाशित किया जाता है; स्रोत प्रत्येक लेख के अंत में दिए जाते हैं।
हमारी संपादकीय नीति पढ़ें